Pour les chercheurs
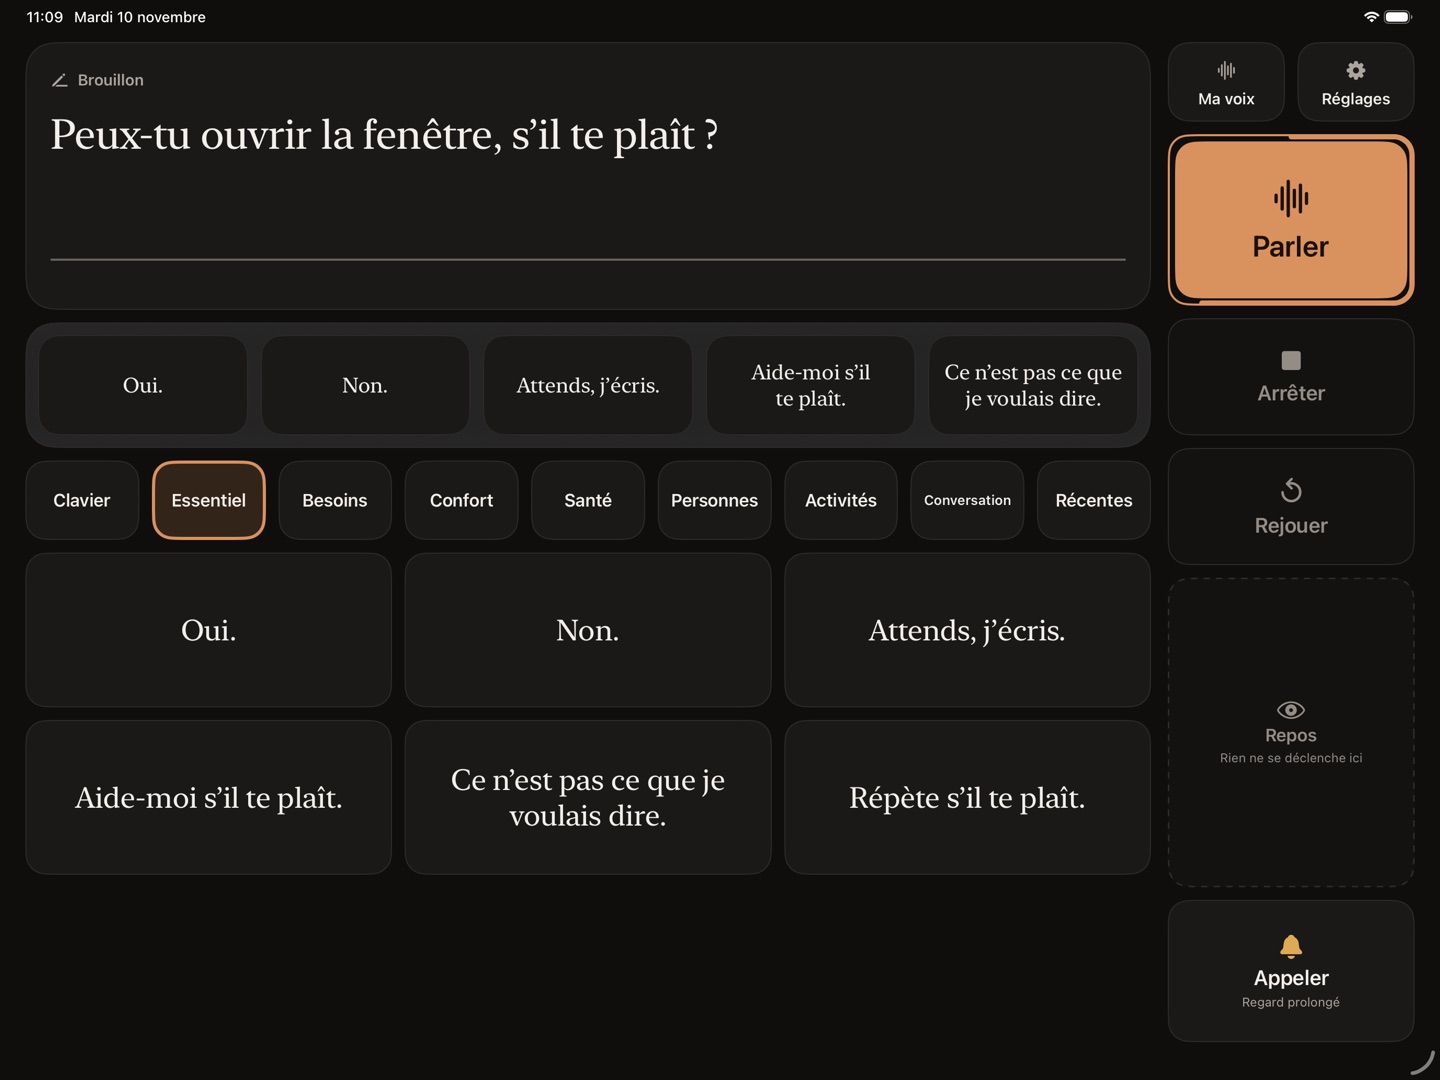
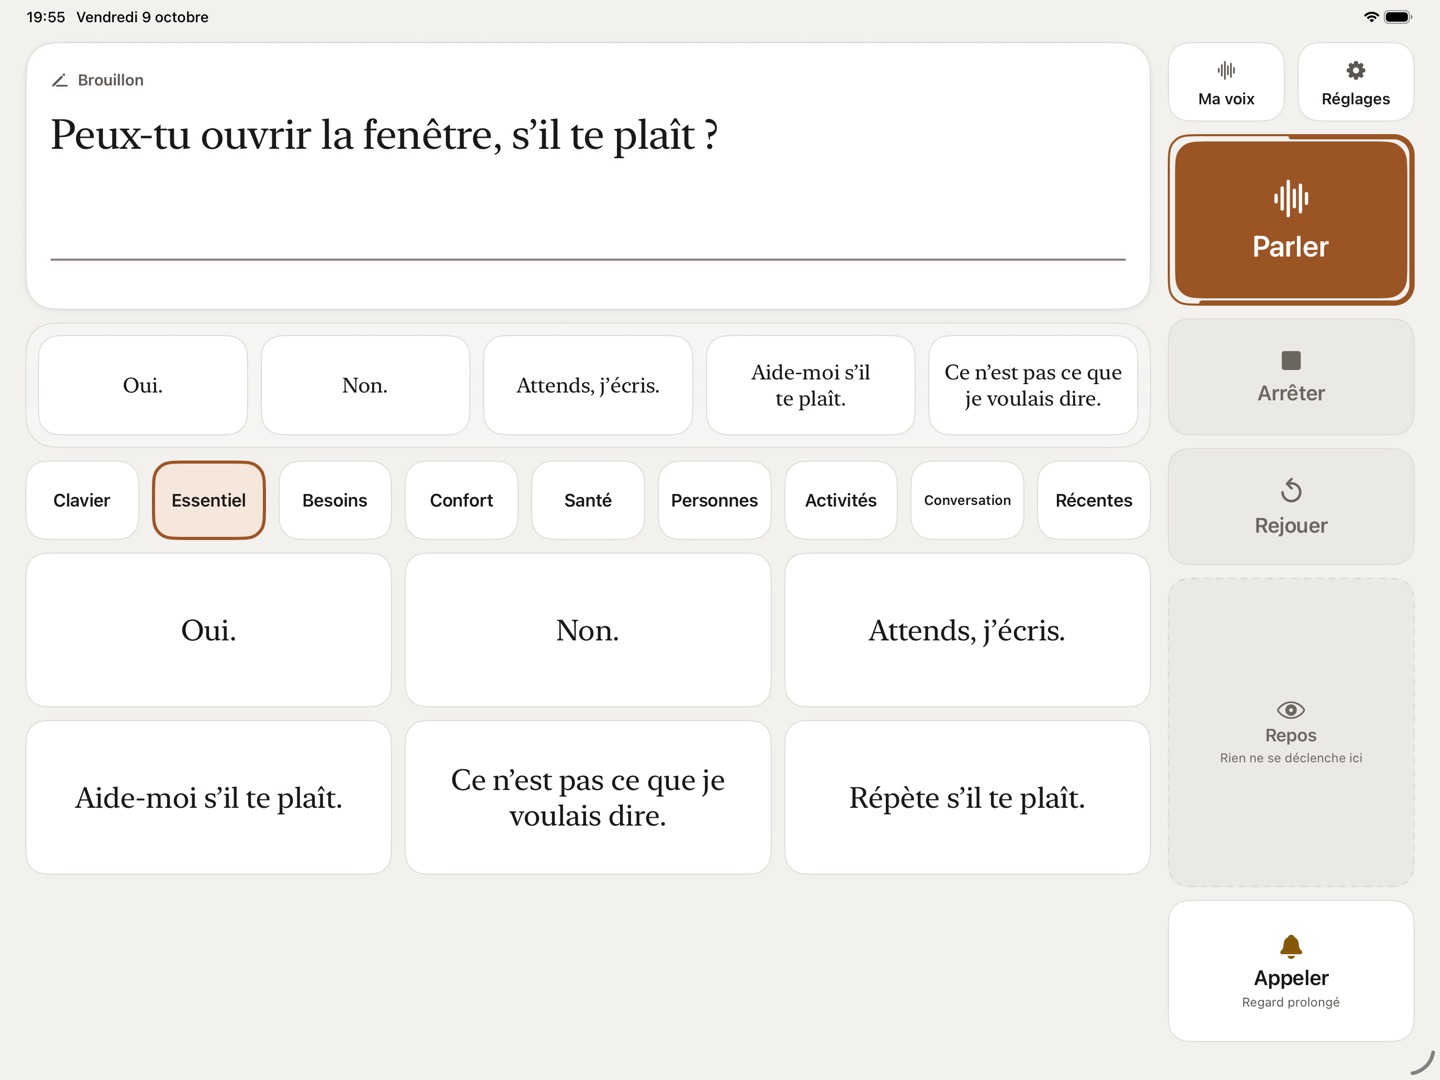
VoiceForever fait tourner sur un seul iPad, sans serveur, une synthèse vocale qui reprend la voix d’une personne et un suivi du regard par la caméra frontale. Voici comment, et comment le mesurer.
Une architecture entièrement locale
Pas de compte, pas d’API distante, pas de service d’analyse. L’inférence se fait sur le GPU de l’iPad avec MLX, depuis une app Swift.
Dans l’iPad
-
Regard
- Caméra frontale
- Suivi du visage ARKit
- Moteur de regard VoiceForever : calibration, choix de la cible
- Phrase ou touche choisie par fixation
-
Voix
- Texte écrit
- Qwen3-TTS sur MLX, conditionné par un extrait de référence et sa transcription
- Audio lu pendant la génération
-
Transcription
- Microphone
- Parakeet (NVIDIA) sur MLX
- Transcription relue par la personne
-
Suggestions
- Phrase en cours
- Vocabulaire de la personne, correcteur d’iPadOS, modèle embarqué d’Apple si l’iPad le permet
- Mots et phrases suggérés
Ce qui entre, une fois : les modèles, téléchargés depuis Hugging Face à une révision épinglée.
Ce qui sort, si la personne le décide : un rapport technique, un export de profil, une trace du regard.
Les modèles
Qwen3-TTS pour la voix (licence Apache-2.0) et Parakeet de NVIDIA pour la transcription (licence CC BY 4.0), tous deux convertis pour MLX. Chacun est épinglé à une révision : l’app télécharge exactement ces fichiers. La voix légère est celle proposée par défaut ; la voix haute qualité reste au choix, pour les iPad qui ont assez de mémoire.
| Modèle | Rôle | Taille | Dépôt et révision |
|---|---|---|---|
| Qwen3-TTS 0.6B Base 8-bit | Voix | 2,0 Go | mlx-community/Qwen3-TTS-12Hz-0.6B-Base-8bit @50f45ef0047c |
| Qwen3-TTS 1.7B Base 8-bit | Voix | 3,1 Go | mlx-community/Qwen3-TTS-12Hz-1.7B-Base-8bit @e7dd05856522 |
| Qwen3-TTS 1.7B Base BF16 | Voix | 4,5 Go | mlx-community/Qwen3-TTS-12Hz-1.7B-Base-bf16 @a6eb4f68e4b0 |
| Parakeet TDT 0.6B v3 8-bit | Transcription | 0,9 Go | animaslabs/parakeet-tdt-0.6b-v3-mlx-8bit @18498133db8b |
Les mesures
L’app expose ses propres mesures dans le Mode avancé, à activer dans Réglages, À propos. Elles y sont expliquées en langage courant, avec leurs unités.
Regard
- Erreur médiane et 90e centile, en points d’écran
- Exercice de précision : 40 cibles, puis un temps de repos
- Historique des calibrations
- Export des traces du regard (JSONL) et du rapport de précision (JSON)
Synthèse
- Délai avant le premier son
- Facteur temps réel
- Mémoire utilisée
- Pour chacune des phrases récentes
- Précision du regard sur iPad Sur demande
- Protocole, sessions de calibration enregistrées sur l’appareil, et traces rejouées sur un banc d’essai pour vérifier chaque changement du moteur.
- Performance de la synthèse sur iPad Campagne en cours
- Délai avant le premier son, facteur temps réel et mémoire, pour les deux voix, plusieurs durées de référence et plusieurs longueurs de phrase, avec une écoute à l’aveugle.
Nous ne publions un chiffre qu’avec le rapport qui l’établit. VoiceForever n’a fait l’objet d’aucune étude clinique : ces mesures décrivent le comportement technique de l’app sur un appareil, pas un effet sur la santé.
Nous écrire
Vous évaluez l’app, préparez une étude ou voulez comparer avec votre propre système ? Demandez-nous les rapports ou un échange.